Thursday, August 16, 2012

RAM nội
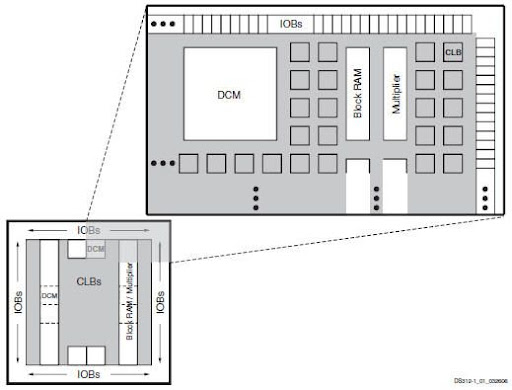
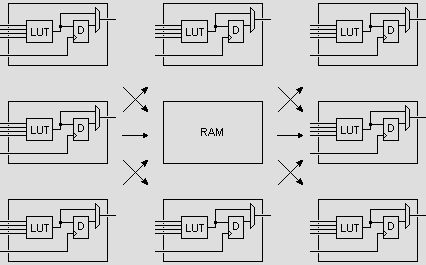
Trong các FPGA sau này đều có các khối RAM tĩnh được điều khiển bởi các thành phần lô-gic
Block RAM - khối RAM trong FPGA
Xử lý của RAM nội
Có rất nhiều thông số tác động lên xử lý của RAM nội. Thông số chính là “số tác nhân” có thể truy cập RAM cùng một lúc.
  • “single-port” RAM (RAM đơn port): chỉ một tác nhân có thể đọc/ghi RAM
  • “dual-port” RAM (RAM 2 port), “quad-port” RAM (RAM 4 port): Có hai/bốn tác nhân có thể đọc/ghi RAM. Mỗi tác nhân có thể sử dụng clock khác nhau, điều này rất quan trọng khi ta cần chuyển dữ liệu từ miền clock này sang miền clock kia.
Để tính xem có bao nhiêu tác nhân có thể truy cập RAM thì ta đếm số bus địa chỉ. Mỗi tác nhân có một bus địa chỉ riêng, một bus đọc dữ liệu và một bus ghi dữ liệu.
RAM 2 port (2 tác nhân truy cập)
Việc ghi vào RAM luôn luôn được thực hiện đồng bộ. Việc đọc cũng vậy nhưng có đôi khi được thực hiện bất đồng bộ.
RAM khối (Blockram) và RAM phân bố (Distributed RAM)
Hiện tại có hai loại RAM nội trong FPGA là RAM khối và RAM phân bố. Kích thước RAM dùng để xác định loại được sử dụng.
Các khối RAM lớn gọi là “RAM khối”, nó được đặt trong các vùng chuyên biệt trong RAM. Mỗi FPGA có một số giới hạn loại RAM này và chúng chỉ có chức năng là RAM chứ không thể dùng cho bất cứ chức năng nào khác.
Các khối RAM nhỏ đặt trong các “RAM khối nhỏ hơn” (Altera) hoặc dưới dạng “RAM phân bố” (Xilinx). “RAM phân bố” cho phép dùng các logic-cell của FPGA như là các RAM cực nhỏ, loại RAM này phân bố linh động trong FPGA mà không gom chung trong một vùng (một logic-cell giống như một RAM cực nhỏ). Altera thì xây dựng các “RAM khối” với kích thước khác nhau đặt khắp trong lịn kiện nhưng độ linh động vẫn không bằng “RAM phân bố”.
FPGA có cấu tạo như thế nào
Cấu tạo cơ bản của FPGA
Các logic-cell
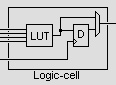
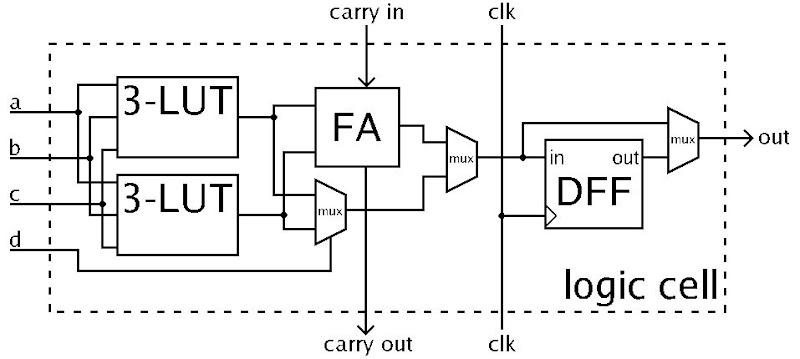
FPGA có cấu tạo từ các logic-cell. Về cơ bản một logic-cell gồm một bảng tra (LUT), một Flip-Flop và một mux 2 sang 1 (để có thể bỏ qua Flip-Flop nếu muốn). Một LUT giống như một RAM nhỏ có thể thực thi một chức năng lô-gic nào đó và LUT có các ngõ vào (input). Ví dụ như hình minh họa là 4 ngõ vào.

Ví dụ về logic-cell
Kết nối logic-cell (Interconnect)
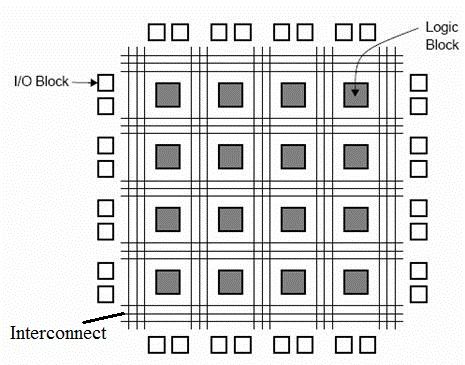
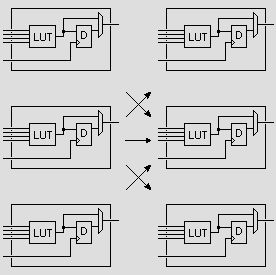
Các logic-cell được kết nối với nhau thông qua các “tài nguyên liên kết”, là các dây nối và mux được đặt xung quanh logic-cell. Mỗi logic-cell có thể nhỏ nhưng có rất nhiều các kết nối đến chúng để có thể tạo ra các chức năng lô-gic phức tạp.
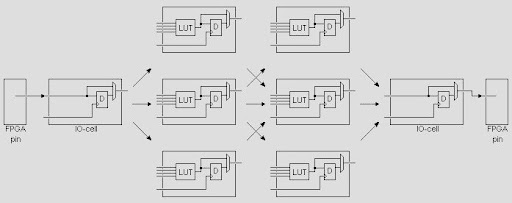
Các IO-cell
Các dây nối còn được đưa đến biên của linh kiện. Biên linh kiện có đặt các IO-cell để kết nối ra các chân của FPGA.
Các chuỗi nhớ và định tuyến chuyên dụng (Dedicated routing/carry chains)
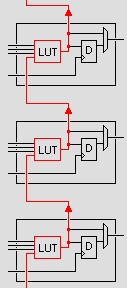
Bên cạnh các kết nối thông thường thì các “tài nguyên kết nối đa năng” cũng được thêm vào. Trong FPGA, các logic-cell liền kề nhau có các đường kết nối nhanh chuyên dụng (fast dedicated lines). Loại đường nhanh chuyên dụng phổ biến nhất là “chuỗi nhớ” (carry chains). Chuỗi nhớ cho phép tạo các chức năng toán học (như bộ đếm và bộ cộng) rất hiệu quả với tài nguyên logic thấp và tốc độ xử lý cao.
Với các công nghệ thấp hơn như PAL hay CPLD thì không có các “chuỗi nhớ” này vì vậy tốc độ bị giới hạn khi các xử lý toán học được yêu cầu.
Tớ xin phép lập cái topic này để trình bày một số vấn đề cơ bản nhằm cung cấp thông tin cho các bạn mới bắt đầu làm quen với FPGA. Các thông tin này chỉ là những tham khảo của cá nhân trên các trang web khác. Mong rằng bạn nào có những kiến thức và thông tin tương tự thì trình bày tiếp cho mọi người cùng học hỏi nhé.
Tớ trình bày với mục đích tạo một cái nhìn dễ hình dung nên từ ngữ đôi khi "không chuyên môn" lắm ^^ mong bỏ quá cho nhé.
FPGA là gì?
FPGA là chip lô-gic số lập trình được. Nghĩa là bạn có thể sử dụng chúng để lập trình hầu hết các chức năng của bất cứ mạng số nào.
Các bước cơ bản khi chúng ta làm việc với FPGA là:
  • Dùng máy tính mô tả một chức năng lô-gic mong muốn. Tức là vẽ sơ đồ mạch chức năng rồi viết code mô tả chức năng đó.
  • Tổng hợp code sử dụng phần mềm được cung cấp bởi các nhà cung cấp FPGA như Quartus của Altera hoặc ISE của Xilinx.
  • Kết nối KIT nạp FPGA với máy tính, và KIT nạp FPGA với KIT FPGA và nạp file binary lên chip FPGA. Với KIT DE1, DE2, phần nạp đã được tích hợp sẵn.
Bạn cần chú ý một số điểm sau:
  • Số lần nạp FPGA: không giới hạn.
  • Dữ liệu (chương trình) nạp trong FPGA bị mất khi ngừng cấp nguồn (mất điện) giống như RAM trong máy tính vậy. Như vậy, muỗn lần ngắt nguồn và bật lại thì ta phải nạp lại FPGA. Muốn lưu giữ lại chức năng đã lập trình cho FPGA thì ta phải mắc thêm ROM ngoài. ROM này có nhiệm vụ lưu file nạp binary và tự động nạp lại cho FPGA mỗi khi bật nguồn như vậy dù có ngắt nguồn FPGA vẫn “không bị mất” dữ liệu.
Công ty nào sản xuất FPGA?
Hiện tại có hai công ty hàng đầu thế giới về các sản phẩm FPGA là XiLinx và Altera. Bên cạnh đó còn có Lattice,  Actel, SiliconBlue
FPGA và CPLD có giống nhau?
FPGA và CPLD đều là linh kiện logic lập trình được nhưng chúng rất khác nhau. Những điểm khác biệt đó là:
FPGA và CPLD đều cấu tạo từ các cell-logic là sự kết hợp của một khối lo-gic và Flip-Flop. Nhưng, FPGA là linh kiện “fine-grain”, nghĩa là mật độ các cell logic lớn(lên đến cả trăm ngàn) vì kích thước các khối lô-gic nhỏ. CPLD là linh kiện "coarse-grain", nghĩa là mật độ các cell logic rất ít (xét trên cùng diện tích với FPGA) vì kích thước các khối lô-gic lớn.
FPGA giống như RAM, phải nạp lại mỗi khi bật nguồn. CPLD giống như EEPROM chỉ cần nạp một lần và không bị mất chức năng sau khi ngắt nguồn.
FPGA có nhiều tài nguyên định tuyến đặc biệt để thực hiện các chức năng toán học như các bộ đếm, bộ cộng, bộ so sánh, v.v… còn CPLD thì không.
FPGA và Vi điều khiển thì sao?
FPGA có các phần tử lô-gic chạy theo dạng song song. Vi điều khiển dựa trên cấu trúc CPU thực thi theo mã lệnh theo dạng tuần tự.
FPGA dùng ngôn ngữ lập trình phần cứng (Verilog, VHDL) và lập trình trên FPGA gọi là lập trình phần cứng. Lập trình vi điều khiển gọi là lập trình phần mềm dựa trên phần cứng có sẵn.
Để thấy được sự khác nhau, Ta có ví dụ như sau. Ta có một chip FPGA, ta sử dụng ngôn ngữ Verilog hoặc VHDL để “viết” ra chức năng của một vi điều khiển. Biên dich và nạp phần thiết kế bằng Verilog hay VHDL này lên FPGA thì con FPGA sẽ như một con vi điều khiển và người lập trình ứng dụng có thể dùng ngôn ngữ như Assemble hay C để lập trình cho con “vi điều khiển FPGA” này như việc lập trình cho các con vi điểu khiển khác mua trên thị trường.

FPGA, góc nhìn từ lập trình cấp cao!

Đây là 1 bài viết hay, đáng lẽ mình chỉ nên đưa đường link. Nhưng do người viết là dân lập trình nên có nhiều đoạn không liên quan đến DT-VT --> cắt bớt ra để mọi người đọc cho dễ:

Sau một thời gian “trằn trọc băn khoăn, tối ngủ ngon lành”, quyết định tổng kết những gì ghi nhận được về FPGA để mai mốt lại ngâm cứu tiếp.

FPGA nói ngắn gọn là “lập trình phần cứng” hay “lập trình chip”. Nó cũng là “lập trình”. Hãy xem xét lập trình ở các cấp độ khác nhau. Ở cấp cao nhất của lập trình, cấp thông dịch, bao gồm các ngôn ngữ như PHP, Python, Ruby… Các chương trình loại này được một chương trình khác chạy và thực hiện từng lệnh một. Thấp hơn một tí là các ngôn ngữ có Virtual Machine (VM) và thực hiện mã giả và Just-In-Time compilation như Java hay .NET. Ở mức này các chương trình sẽ được chuyển từng phần sang mã máy. Đến lượt VM sẽ xử lý các mã giả.

Sau mã giả dĩ nhiên là đến mã thật. Những chương trình thuộc thế hệ cũ như C sẽ được biên dịch trực tiếp ra mã máy, loại lệnh mà CPU có thể đọc hiểu trực tiếp. Đối với các chương trình dùng VM, bản thân VM cũng là một chương trình mà sẽ chuyển mã giả của VM đó sang một tập mã máy và thực thi. Đối với các chương trình thông dịch thì đoạn mã tổng cộng dùng để thực thi to hơn nhiều, bao gồm phân tích cú pháp và gọi các hàm tương ứng với từng lệnh. Với cùng một đoạn lệnh thực hiện cùng một tính năng, đoạn viết bằng C là gọn gàn nhất, được chuyển trực tiếp thành những mã lệnh CPU liên quan trực tiếp đến tính năng cần thực hiện. Với các chương trình dùng VM, đoạn mã lệnh CPU to hơn do là tổ hợp của mã lệnh cho CPU của từng mã giả VM. Với chương trình thông dịch, mã liên quan còn to hơn nữa do dính dáng đến phần phân tích cú pháp.

Như ta thấy, càng đi xuống khối lượng “mã” dùng để thực hiện một tính năng giảm dần, cô đọng dần, tập trung vào cốt lõi của tính năng cần thực hiện. Nhưng! Để ý là mã giả cũng là một tập mã, cũng được phân tích thành một tập các mã thiệt dành cho CPU. CPU cũng có một tập mã, nên trên nguyên tắc các mã lệnh CPU cũng có thể được tách thành một tập các “mã điện tử”!

Không biết có ai đã từng phân vân cách hoạt động của một CPU như thế nào chưa. CPU tuy phức tạp nhưng tất cả các thao tác của CPU đều có thể quy về các phép toán logic và số học. Mỗi khi thực hiện một lệnh, CPU sẽ nhảy qua lệnh kế tiếp. Phép nhảy này, đối với kiến trúc x86, đơn giản là cộng thêm vào thanh ghi IP độ dài của mã lệnh vừa thực hiện (Với ARM còn dễ hơn, cứ cộng 4 vào r15 vì kích thước mã lệnh trong kiến trúc RISC là cố định). Phép nhảy đến một địa chỉ. Phép nhảy có điều kiện có thể quy ra là phép cộng với tích của kết quả biểu thức có điều kiện (trả về 1 hoặc 0) với khoảng cách cần nhảy. Nếu điều kiện là đúng, trả về 1, thì IP được cộng thêm vào, nói cách khác là nhảy. Nếu điều kiện sai, trả về 0, thì IP vẫn giữ nguyên. Như vậy có thể nói hầu hết các phép toán của CPU đều có thể biến thành AND OR NOT XOR với cộng trừ nhân chia. Trong khi cộng trừ nhân chia cũng có thể biến thành AND OR NOT XOR!

Như vậy có thể thấy ta có thể chuyển các một chuỗi mã lệnh cho CPU về một mớ cổng logic nối với nhau (giả bộ thế). Khi đã chuyển về như thế, ta có thể tìm ra những chỗ thừa thãi và loại bỏ bớt các cổng logic không cần thiết sao cho kết quả cuối cùng vẫn giữ nguyên. Làm như thế nghĩa là đã loại bỏ CPU ra khỏi quá trình thực hiện chương trình. Chương trình ban đầu giờ đây biến thành một tập các cổng logic (tạm thời quên đi việc truy cập bộ nhớ và các thiết bị phần cứng khác). Thậm chí ngay cả không tối ưu các cổng logic, ta vẫn giảm được thời gian xử lý do loại phần phân tích lệnh và nhảy lệnh của CPU (cũng giống như công việc của trình thông dịch). FSM (lát nữa nói) của một chương trình cụ thể sẽ đơn giản hơn nhiều so với một CPU tổng quát.

Như mô tả, cuối cùng thì chương trình được “lập trình” không còn sử dụng CPU nữa. Và kết quả chương trình không phải là một tập mã máy mà là một sơ đồ các cổng logic. Vậy cần có một ngôn ngữ để “vẽ” mấy cái sơ đồ mạch đó, bằng chữ (rõ ràng vẽ hình thì rất khó kiểm tra giám sát, mà máy tính lại ngu, không giỏi đọc hình bằng đọc chữ). Các ngôn ngữ này được gọi là Hardware Description Language, phổ biến là VHDL và Verilog. Nếu coi mấy cái sơ đồ logic đó là “mã máy” theo cách nhìn của dân làm phần mềm thì rõ ràng chẳng ai điên đi viết trực tiếp trên mấy cái đó cả (tệ tương đương viết hợp ngữ). Do đó HDL sẽ được dùng để mô tả tổng quát hơn và sẽ có một cái “trình biên dịch” để biến cái mô tả đó thành “mã máy” (dân chip gọi là netlist thì phải).

Như vậy, ta có thể nhìn thấy việc “lập trình phần cứng” đơn giản chỉ là một bước tiếp theo của dây chuyền “thông dịch, mã giả, máy ảo, JIT, biên dịch, mã máy”. Mặc dù kỳ dị nhưng vẫn chấp nhận được, từ quan điểm lập trình viên. Quay lại FPGA. Đơn vị cơ bản của FPGA là macrocell tuy nhiên vẫn không rõ macrocell là gì. Nó có vẻ phức tạp hơn cổng logic. Macrocell đối với FPGA cũng giống như mã máy CPU đối với lập trình phần mềm. Đó là nền tảng lập trình. FPGA có một lượng macrocell khá là lớn nên có thể vô tư thiết kế. Khi “lập trình FPGA”, ta nối các macrocell này lại với nhau, như thể ta lấy các mã lệnh CPU cho vào danh sách theo một thứ tự nhất định vậy. Mặc dù nối macrocell thì nhiều chân hơn, nối tùm lum hơn là cái danh sách mã lệnh một chiều thẳng đuột của lập trình phần mềm. Việc ghi “chương trình” vào FPGA được thực hiện thông qua giao tiếp JTAG. Nói đơn giản, JTAG cho phép ta trực tiếp đưa tín hiệu vào các chân của một con chip cụ thể trên board mà không cần quan tâm đến mấy thứ còn lại trên board, như thể ta tháo con chip đó ra và mần thịt riêng mình nó.

Thao tác ở mức phần cứng đòi hỏi nhiều thứ hơn là chỉ “sơ đồ các cổng logic”. Một trong những thứ đó là điều khiển chức năng của các chân: liệu chân này là chân vào, chân ra, hay chân gãy (điện trở cao, cấm cả vào lẫn ra)... Làm việc với cổng logic cũng có nhiều cái thú vị hơn lập trình cấp cao hơn. Ví dụ như mạch flip-flop, xem như một bit nhớ đơn giản. Ngoài ra còn có một khái niệm khác có ở cấp lập trình cao hơn nhưng không tồn tại ở cấp FPGA: việc chạy tuần tự các lệnh. Với mạch điện thì chỉ cần cho điện ở cổng vào là toàn mạch chạy hết, không có cái gì tuần tự hết. Tuần tự được là nhờ hai thứ: flip-flop để ghi nhớ trạng thái và chân xung nhịp đầu vào để hoạt động theo từng xung một. Ta có thể viết mô tả HDL để một mớ cổng logic (hay macrocell gì gì đó) hoạt động khi có xung đồng hồ (một cổng AND là hết) và lưu kết quả vào flip-flop. Ta lại viết một mô tả khác cho một mớ cổng logic hoạt động khi có xung đồng hồ và kết quả của cổng flip-flop vừa lưu là 1 (ví dụ thế). Ở đây một tập các flip-flop sẽ hoạt động như bộ nhớ lưu lại trạng thái cuối cùng của chip. Nhiệm vụ của ta là vẽ ra một máy trạng thái hữu hạn (Finite state machine) trên giấy mô tả các bước thực hiện và sau đó chuyển sang vẽ mạch. À dĩ nhiên là không đến nỗi phải vẽ mạch. Verilog khá dễ viết và dễ hiểu nên cũng không đến nỗi. Verilog cũng hỗ trợ luôn các biểu thức số học và biểu thức logic phức tạp nên càng khoẻ. Ai quan tâm thì đọc tiếp trang 53 cuốn “The Verilog Hardware Description Language, fifth edition” của Thomas và Moorby (ai có cuốn nào hay hơn, chỉ dùm cái).

Với việc có thể biến FSM thành mạch một cách dễ dàng, có thể nói ta muốn làm gì cũng được. Chương trình lớn thế nào cũng biến thành mạch được (“A Turing machine is a finite-state machine associated with an external storage or memory medium.”—Minsky (1967), p. 117) Chạy được hay không là chuyện khác! Bởi vì...

* Bởi vì phần cứng thì mắc hơn phần mềm, không có tiền là không có thử cái gì hết
* Bởi vì không có nhiều công cụ hỗ trợ trên Linux. Chỉ có thể kiếm ra icarus verilog, gtkwave và gplcver. Cả icarus verilog vẫn cần bộ Xilinx Foundation. Còn nguyên bộ Xilinx ISE gì gì đó thì giá trên trời. Lại ca bài ca tiền là tiền nhiều khi không mà có, tiền là tiền nhiều khi có mà .. hổng đủ
* Bởi vì phần cứng có tác động của các yếu tố “cứng” như độ trễ của các cỗng logic, độ lệch của xung nhịp, độ dốc của xung… mà mô phỏng phần mềm thì chưa chắc đúng. Còn dùng thiết bị debug chuyên dụng thì lại ca bài ca “tiền là tiền nhiều khi…”
* Bởi vì lười quá nên biết làm sao. Thôi kệ nó.

Túm lại FPGA là thế. FPGA không phải là thần thánh gì. FPGA cũng là lập trình thôi (dù đỏi hỏi một chút hiểu biết về điện tử). FPGA giúp ta đạt được tốc độ nhanh hơn vì loại cả thằng CPU to vật vã ra. FPGA giúp ta trở nên nhỏ hơn (một con chip chứa cả bầu trời!).Nhưng FPGA vẫn chưa là vô địch. Vô địch là ASIC. Với ASIC, FPGA giúp ta tạo ra sản phẩm rẻ hơn (với điều kiện chế tạo số lượng lớn). Và cho dù có thể dùng FPGA để viết cả CPU, đừng mơ đến việc viết một con CPU (chấp làm ASIC luôn) mà có thể qua mặt Intel :)

Cuối cùng cũng phải dành một dòng để nhắc đến một dự án đầy tham vọng có sử dụng FPGA: Open Graphics Project. Hi vọng dự án thành công tốt đẹp.

source: http://dev.gentoo.org/~pclouds/blog/arc ... index.html
thank and sorry pclouds.

Sunday, July 15, 2012

Một số hệ thống chấm bài tự động trên Internet

 ACM.UVA.ES
1.     Tổng quan
ACM UVA, được phát triển bởi trường đại học Valladolid - Tây Ban Nha,
 là một trong những hệ thống online judge sớm nhất trên thế giới. Đây có lẽ là trang online judge có nhiều thành viên nhất, bao gồm hầu hết các lập trình viên giỏi trên thế giới. Ngòai hệ thống bài tập, trang web còn thường xuyên tổ chức các kì thi (contests) cho tất cả mọi người tham gia, trong đó có nhiều kì thi lớn.
2.     Hệ thống bài
Trang web này có một hệ thống bài tập rất lớn, bao gồm khỏang 1600 bài chia thành nhiều volumes, đề bài do các cộng tác viên gửi đến hay lấy từ những contests đã diễn ra. Chất lượng các bài tập gồm nhiều lọai, từ rất dễ, dễ đến khó hay rất khó. Do bài tập chủ yếu phục vụ luyện tập cho kì thi ACM, nên một số bài đòi hỏi phải có một kỹ năng phân tích đề bài tốt và một kỹ năng lập trình chính xác. Trên thực tế, một số bài có phần đề tương đối khó hiểu, đòi hỏi phải đọc kỹ; và khi làm bài chỉ khi nào bạn qua được hết các test thì mới được công nhận, chứ không có chuyện tính điểm theo từng test.
3. Hệ thống thi
Muốn biết trang web này sắp tổ chức kì thi nào, bạn cần vào trang chủ để theo dõi. Các kì thi diễn ra trong một giờ cố định (thường là 3 đến 6 tiếng bắt đầu từ 16h giờ VN). Tùy theo kì thi mà chất lượng bài ở mức khó hay dễ.
4. Viết chương trình
- ACM UVA hỗ trợ trình biên dịch Free Pascal, C, C++, Java, ...
- Khi viết chương trình bằng pascal, bạn cần lưu ý input/output phải là input/output chuẩn (standard ). Cụ thể là bạn không được khai báo các lọai kiểu file, và các lệnh nhập xuất Read, Write phải để không có tham số f giống như khi nhập/ xuất từ màn hình, bàn phím. Bạn cũng không được phép có các lệnh như assign, reset, rewrite, ...

WWW.USACO.ORG
1.     Tổng quan
USACO là trang Web của Mỹ nhằm mục đích huấn luyện đội tuyến quốc gia Mỹ tham dự kì thi IOI hàng năm. Web Site này còn có phần training cho tất cả mọi người tham gia, ngòai ra hàng tháng trang web còn tổ chức kì thi lập trình online. Các kì thi này rất đáng quan tâm bởi nó thu hút được rất nhiều học sinh giỏi trên thế giới.
2.     Hệ thống bài
Phần training của USACO bao gồm những hệ thống bài tập và lý thuyết được chia làm 6 sections, mỗi section được chia làm nhiều chapters. Mỗi username mới đăng ký sẽ được truy cập và section 1 – chapter 1, sau khi hòan thành hết các bài tập trong chapter, bạn sẽ được truy cập vào chapter kế tiếp. Sau khi giải xong một bài, bạn được quyền xem lời giải mẫu (solutions) và code mẫu (bằng c hoặ c c++)
3.     Hệ thống thi
Thông thường, từ tháng 11->3 USACO sẽ tổ chức mỗi tháng một kì thi, gọi là Monthly Contests. Mỗi kì thi bao gồm ba bảng – Bronze , Silver và Gold. Nếu bạn tham gia bảng Bronze hay Silver mà đạt được một số điểm nhất định thì sẽ được lên bảng cao hơn. Đến tháng 4-5 USACO sẽ tổ chức kì thi US Open, trong đó sẽ có một ngày dành cho tất cả mọi người tham gia. Nhìn chung đề thi USACO hay và khó.
4.      Viết chương trình
USACO hỗ trợ Free Pascal, C, C++,...
Chương trình của bạn viết bằng Pascal hòan tòan giống như khi đi thi, nghĩa là cũng đọc file, xuất file từ đĩa.

SPOJ.SPHERE.PL
1.     Tổng quan
SPOJ do một nhóm sinh viên của trường đại học GDANSK, Ba Lan thành lập. Tuy mới họat động chính thức được hơn 1 năm, nhưng SPOJ cũng thu hút được nhiều người tham gia, trong đó có những học sinh Việt Nam. Những tính năng nổi bật hiện nay của SPOJ là tính đa dạng của việc chấm bài (có thể chấm gần đúng, chấm theo test, ...), giao diện thân thiện, hệ thống xếp hạng thành viên chặt chẽ và hỗ trợ rất nhiều ngôn ngữ lập trình.
2.     Hệ thống bài
Hệ thống bài tập trên SPOJ do các problem setters tuyển chọn từ nhiều kì thi trên thế giới, trong đó có kì thi tin học Ba Lan (POI), bao gồm rất nhiều bài tập hay và khó. Ngòai ra cũng có một số bài tutorial khá dễ để các thành viên làm quen. Đặc biệt, có một lượng các bài tập hay và hòan tòan mới lấy từ kì thi DASM do chính các admin của website này ra đề.
3.     Hệ thống thi
Năm vừa rồi ,SPOJ đã tổ chức kì thi DASM Programming League, diễn ra trong vòng 1 năm, được chia thành nhiều problem sets. Điểm của một cá nhân trong tòan bộ kì thi sẽ là điểm của mỗi problem set cộng lại. Không rõ kì thi này có được duy trì nữa hay không.
SPOJ còn hỗ trợ tổ chức các hệ thống contest khác, tuy nhiên các hệ thống này thường chỉ là nội bộ và không thường xuyên.
4.     Viết chương trình
SPOJ hiện hỗ trợ trình biên dịch Free Pascal 2.0, ngòai ra bạn còn có thể dùng C, C++, Java và nhiều ngôn ngữ lạ như HASK, Intercal,...
Khi viết chương trình bằng Pascal bạn cũng lưu ý input/ output phải là input/output chuẩn. Một cách tiện lợi nhất đó là khi nộp bài bạn chỉ cần sửa lại phần khai báo const finp=’’; thay vì const finp=’tenfile.inp’; như khi viết trên máy tính. Tương tự đối với khai báo file output

Một số trang web khác

ACM.TIMUS.RU
Trang web giải bài online của Rumani, cũng có nhiều bài tập khá hay.

ACM.PKU.CN
Trang web giải bài online của Trung Quốc, cũng có nhiều bài tập khá hay.

WWW.IOICAMP.COM
Hệ thống giải bài trực tuyến của trang web này đang được xây dựng
<<Trích http://vnoi.info/>>

Wednesday, June 6, 2012

Đẩy dữ liệu cho MetaData

use [QLDT_tiensi]
DECLARE @tbName nvarchar(100)
declare @colName nvarchar(100)
DECLARE @lst CURSOR

SET @lst = CURSOR FOR
    SELECT table_name, column_name
    FROM INFORMATION_SCHEMA.COLUMNS
   
OPEN @lst

FETCH NEXT
FROM @lst INTO @tbName,@colName

WHILE @@FETCH_STATUS = 0
BEGIN
    print @tbname + ' ' + @colName
    if (not exists( select * from tbMeta where tenbang = @tbName and tentruong = @colName))
        insert into tbMeta(tenbang,tentruong, dorong, [text],[control]) values(@tbName,@colName, 80,'','TextBox');   
FETCH NEXT
FROM @lst INTO @tbName,@colName
END
CLOSE @lst
DEALLOCATE @lst